Selasa, 11 Desember 2018

UJI CHI KUADRAT (χ2)


NAMA       :   LA INYO
NPM           :   17 630 007


UJI CHI KUADRAT (χ2)
PENGUJIAN HIPOTESIS DESKRIPTIF
(STATISTIK NON PARAMETIK)
CHI KUADRAT (χ2)

1.            Pengertian Chi Kuadrat

Chi Kuadrat (χ2) satu sampel adalah teknik statistik yang digunakan untuk menguji hipotesis bila dalam populasi terdiri atas dua atau lebih klas dimana data berbentuk nominal dan sampelnya besar.

Rumus dari Chi Kuadrat ialah sebagai berikut.
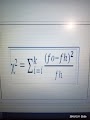


Dimana
χ2    =  Chi Kuadrat
fo      =  Frekuensi yang di observasi
fh      =  Frekuensi yang diharapkan

2.            Ketentuan Pemakaian Chi-Kuadrat (χ2)

Agar pengujian hipotesis dengan Chi Kuadrat dapat digunakan dengan baik, maka hendaknya memperhatikan ketentuan-ketentuan sebagai berikut :

a.       Jumlah sampel harus cukup besar untuk meyakinkan kita bahwa terdapat kesamaan antara distribusi teoritis dengan distribusi sampling Chi Kuadrat.

b.      Pengamatan harus bersifat independen (unpaired). Ini berarti bahwa jawaban satu subjek tidak berpengaruh terhadap jawaban subjek lain atau satu subjek hanya satu kali digunakan dalam analisis.

c.       Pengujian Chi Kuadrat hanya dapat digunakan pada data deskrit (data frekuensi atau data kategori) atau data kontinu yang telah dikelompokan menjadi kategori.

d.      Jumlah frekuensi yang diharapkan harus sama dengan jumlah frekuensi yang diamati.

e.       Pada derajat kebebasan sama dengan 1, tidak boleh ada nilai ekspektasi yang sangat kecil. Secara umum, bila nilai yang diharapkan terletak dalam satu sel terlalu kecil (< 5) sebaiknya Chi Kuadrat tidak digunakan karena dapat menimbulkan taksiran yang berlebih (over estimate) sehingga banyak hipotesis yang ditolak kecuali dengan koreksi dari Yates. Bila tidak cukup besar, maka adanya satu nilai ekspektasi yang lebih kecil dari 5 tidak akan banyak mempengaruhi hasil yang diinginkan. Pada pengujian Chi Kuadrat dengan banyak ketegori, bila terdapat lebih dari satu nilai ekspektasi kurang dari 5 maka, nilai-nilai ekspektasi tersebut dapat digabungkan dengan konsekuensi jumlah kategori akan berkurang dan informasi yang diperoleh juga berkurang.


3.            Contoh Soal

Berikut ini dikemukakan Chi Kuadrat untuk menguji hipotesis deskriptif (satu sampel) yang terdiri atas dua kategori dan empat kategori atau kelas.

·         Contoh 1, untuk dua kategori:

Telah dilakukan pengumpulan data untuk mengetahui bagaimana kemungkinan rakyat di Kecamatan Pasarwajo dalam memilih dua calon kepala desa. Calon yang satu adalah wanita dan calon yang kedua adalah pria. Sampel sebagai sumber data diambil secara random sebanyak 300 orang. Dari sampel tersebut ternyata 200 orang memilih pria dan 100 orang memilih wanita.

Hipotesis yang diajukan adalah:
Ho: peluang calon pria dan wanita adalah sama untuk dapat dipilih menjadi kepala desa.
Ha: peluang calon pria dan wanita adalah tidak sama untuk dapat di pilih menjadi kepala desa.

Untuk dapat membuktikan hipotesis dengan rumus tersebut diatas, maka data yang terkumpul perlu disusun ke dalam tabel seperti tabel berikut.

KECENDRUNGAN RAKYAT DI KECAMATAN
PASARWAJO DALAM MEMILIH KEPALA DESA

Alternatif Calon Kepala Desa
Frekuensi yang diperoleh
Frekuensi yang diharapkan
Calon Pria
Calon Wanita
200
100
150
150
Jumlah
300
300

Catatan: Jumlah frekuensi yang diharapkan adalah sama yaitu 50% : 50% dari seluruh sampel.

Untuk dapat menghitung besarnya Chi Kuadrat (χ2) dengan menggunakan rumus tersebut diatas maka diperlukan tabel penolong seperti yang ditunjukkan pada tabel berikut.


TABEL PENOLONG UNTUK MENGHITUNG CHI KUADRAT
DARI 300 ORANG SAMPEL

Alternatif Pilihan
fo
fh
fo - fh
(fo – fh)2
(fo – fh)2/ fh
Pria
Wanita
200
100
150
150
50
-50
2500
2500
16,67
16,67
Jumlah
300
300
0
5000
33,33

Catatan: Disini frekuensi yang diharapkan (fh) untuk kelompok yang memilih pria dan wanita = 50%. Jadi, 50% x 300 = 150

Harga Chi Kuadrat dari perhitungan dengan rumus diatas ditunjukkan pada tabel di atas yakni jalur paling kanan yang besarnya 33,33.

Untuk dapat membuat keputusan tentang hipotesis yang diajukan diterima atau di tolak, maka harga chi kuadrat tersebut perlu dibandingkan dengan Chi Kuadrat tabel dengan dk dan taraf kesalahan tertentu. Dalam hal ini berlaku ketentuan bila Chi Kuadrat hitung lebih kecil dari tabel, maka Ho diterima, dan apabila lebih besar atau sama dengan () harga tabel maka Ho ditolak.

Derajat kebebasan untuk Chi Kuadrat tidak tergantung pada jumlah individu dalam sampel. Derajat kebebasan akan tergantung pada kebebasan dalam mengisi kolom-kolom pada frekuensi yang yang diharapkan (fh) setelah disusun kedalam tabel berikut ini.
Kategori
I
A
M
II
B
N
(a + b)
(m + n)

Dalam hal ini frekuensi yang diobservasi (fo) harus sama dengan frekuensi yang diharapkan (fh). Jadi (a + b) = (m + n) dengan demikian kita mempunyai kebebasan untuk menetapkan frekuensi yang diharapkan (fh) = (m + n). Jadi kebebasan yang dimiliki tinggal satu yaitu kebebasan dalam menetapkan m atau n. Jadi untuk model ini derajat kebebasannya (dk) = 1.

Berdasarkan dk = 1 dan taraf kesalahan yang kita tetapkan 5% maka harga Chi Kuadrat tabel = 3,841. Ternyata harga Chi Kuadrat hitung lebih besar dari tabel (33,33 > 3,841). Sesuai ketentuan kalau harga Chi Kuadrat hitung lebih besar dari tabel, maka Ho ditolak dan Ha diterima. Jadi, kesimpulannya, hipotesis nol yang diajukan bahwa peluang pria dan wanita sama untuk dipilih menjadi kepala desa di kabupaten itu ditolak. Hasil penelitian menunjukkan bahwa masyarakat di kabupaten itu cenderung memilih pria menjadi Kepala Desa.


·         Contoh Soal 2, untuk empat kategori

Telah dilakukan penelitian untuk mengetahui bagaimana kemungkinan beberapa warna mobil dipilih oleh masyarakat Madura. Berdasarkan pengamatan selama 1 minggu terhadap mobil-mobil pribadi ditemukan 1000 berwarna biru, 900 berwarna merah, 600 berwarna putih, dan 500 berwarna yang lain.
Ho : Peluang masyarakat Madura untuk memilih empat warna mobil adalah sama.
Ha : Peluang masyarakat Madura untuk memilih empat warna mobil tidak sama.

Untuk menguji hipotesis tersebut di atas, maka data hasil pengamatan perlu disusun ke dalam tabel penolong, seperti ditunjukkan pada Tabel berikut. Karena dalam penelitian ini terdiri dari empat kategori, maka derajat kebebasannya adalah (dk) = 4 -1 = 3. 


FREKUENSI YANG DIPEROLEH DAN DIHARAPKAN
DARI 300 WARNA MOBIL YANG DIPILIH
OLEH MASYARAKAT PASARWAJO

Warna Mobil
fo
fh
fo - fh
(fo – fh)2
(fo – fh)2/ fh
Biru
Merah
Putih
Warna lain
1.000
900
600
500
750
750
750
750
250
150
-150
-250
62.500
22.500
22.500
62.500
83,33
30,00
30,00
83,33
Jumlah
3000
3000
0
170.000
226,67

Catatan: Frekuensi yang diharapkan (fh) untuk setiap kategori adalah 3000 : 4 = 750

Berdasarkan dk = 3 dan kesalahan 5%, maka diperoleh harga Chi Kuadrat Tabel = 7,815. Ternyata harga Chi Kuadrat hitung lebih besar dari harga Chi Kuadrat Tabel (226,67 > 7,815). Karena (χ2) hitung > dari (χ2) tabel, maka Ho ditolak dan Ha diterima. Ini berarti peluang masyarakat Madura untuk memilih empat empat warna mobil berbeda atau tidak sama. Berdasarkan data sampel ternyata warna mobil biru yang mendapat peluang tertinggi untuk dipilih masyarakat Madura. Ini juga berarti mobil warna biru yang paling laku di masyarakat itu.


Rabu, 05 Desember 2018

KONSEP DASAR PENGAMBILAN SAMPEL


NAMA : LA INYO
NPM     : 17630007

KELAS  A

-          Konsep Dasar Pengambilan Sampel

       Pelaksanaan penelitian selalu berhadapan dengan objek yang diteliti atau yang diselidiki . Objek tersebut dapat berupa manusia,hewan,tumbuhan,benda mati,dan sebagainya. Dalam melakukan penelitian kadang – kadang penelitiannya    melakukannya terhadap seluruh objek (sensus),tetapi sering juga peneliti hanya mengambil sebagian saja dari seluruh objek yang telah disurvey. Meskipun penelitian hanya mengambil sebagian dari seluruh objek yang di teliti,tetapi hasilnya dapat mewakili atau mencakup seluruh objek yang diteliti. Keseluruhan objek penelitian atau objek yang diteliti tersebut adalah populasi penelitian atau universe. Sedangkan sebagian yang diambil darikeseluruhan objek yang diteliti dan dianggap mewakili seluruh populasi ini disebut “Sampel Penelitian”. Dalam mengambil sampel penelitian ini digunakan cara atau teknik – teknik tertentu ,sehingga sampel tersebut sedapat mungkin mewakili populasinya. Teknik ini biasa disebut “Teknik Sampling”. Dalam penelitian survey teknik sampling ini sangat penting dan perlu diprhatikan masak – masak  ,sebab teknik pengambilan sampel tak baik akan mempengaruhi validitas hasil penelitian tersebut.

            Faktor yang berpengaruh pada pengambilan sampel antara lain :

a.       Batasan Populasi

       Suatu populasi menunjukan pada sekelompok subjek yang menjadi objek sasaran penelitian. Apabila tidak dilakukan penelitian terhadap populasi,maka kesimpilan yang ditarik dari hasil penelitian ,maka hasil kesimpulan yang ditarik dari hasil penelitian tidak menggambarkan atau mewakili seluruh populasi. Tanpa pembatasan yang jelas anggota populasi,kita tidak memperoleh sampel yang representative. OKI dalam penilitian apapun populasi tersebut harus dibatasi, misalnya satu wilayah kelurahan,kecamatan,atau kabupaten, kelompok umur +3,penyakit +3,dan sebagainya. Perlu diingat disini ialah bahwa nilai suatu hasil penelitian bukan di tentukan oleh besar kecilnya suatu populasi,melainkan oleh bagaimana penelitian menggunkan dasar pengambilan kesimpulan atau teknik sampling.

b.      Mendaftar seluruh unit yang menjadi anggota populasi

       Seluruh unit yang menjadi anggota populasi dicatat secara jelas, sehingga dapat diketahui unit yang termasuk pada populasi dan unit mana yang tidak

c.       Menentukan sampel yang akan dipilih
d.      Menentukan teknik sampel

Prosedur pengambilan sampel

a.       Menentukan tujuan penelitian
b.      Menentukan populasi penelitian
c.       Menentukan jenis data yang diperlukan
d.      Menentukan teknik sampling
e.       Menentukan unit sampel yang diperlukan
f.       Menentukan besarnya sampel/sampel size
g.      Memilih sampel


-          Analisa Metode Pengambilan Sampel

Menentukan Jumlah Sampel Dengan Rumus Slovin

       Pertanyaan dalam sering kali diajukan dalam metode pengambilan sampel adalah berapa jumlah sampel yang dibutuhkan dalam penelitian. Sampel yang terlalu kecil dapat menyebabkan penelitian tidak dapat menggambarkan kondisi populasi yang sesungguhnya. Sebaiknya sampel yang terlalu besar dapat mengakibatkan pemborosan biaya penelitian.

       Salah satu metode yang digunakan untuk menentukan jumlah sampel adalah menggunakan rumus slovin sebagai berikut:


Dimana
n : jumlah sampel
N : jumlah populasi
e : batas toleransi kesalahan (error tolerance)

       Untuk menggunakan rumus ini, pertama di tentukan berapa batas toleransi kesalahan. Batas toleransi kesalahan ini di nyatakan dengan presentase. Semakin kecil toleransi kesalahan, semakin akurat sampel menggambarkan populasi. Misalnya penelitian dengan batas kesalahan 10% berarti memiliki tingkat akurasi 90%. Penelitian dengan batasa kesalahan 4% memiliki tingkat akurasi 96%. Dengan jumlah yang sama, semakin kecil toleransi kesalahan, semakin besar jumlah sampel yang dibutuhkan.


Contoh Soal

1.      Sebuah perusahaan memiliki 1000 karyawan dan akan dilakukan survey dengan mengambil sampel. Berapakah sampel yang dibutuhkan apabila batas toleransi kesalahan 5%.
                                                                       Jawab              


2.      Disebuah kebun binatang  dihuni 1500 hewan dengan berbagai spesies, berapakah sampel yang dibutuhkan jika toleransi kesalahan 10%.
                                                                              Jawab                   


UJI ANOVA,dan UJI BEDA RATA-RATA


  NAMA         :   LA INYO
  NPM             :   17630007

UJI ANOVA ,DAN UJI BEDA RATA – RATA

         Ada 3 jenis analisis data : univariat, bivariat dan multivariat. Bivariat berarti 2 variabel. Dalam posisi kerangka konsep penelitian, 2 variabel tersebut menempati posisi 1 variabel sebagai variabel independen (mempengaruhi) dan 1 variabel sebagai dependen variabel (variabel terpengaruh). Dalama analisis dua sisi (2 side) tidak dapat ditentukan mana variabel independen dan mana variabel dependen. Peneliti sendiri yang menterjemahkan variabel tersebut. Analisis data menggunakan komputer, bila kedua variabel tersebut diputar - letakkan, maka hasilnya akan sama (bukti).
        Berdasarkan bentuk data (kategorik/numerik), maka ada 4 kemungkinan pasangan variabel yang akan diuji dalam analisis bivariate, yaitu :

1. Kategoriikk - kategorik
2. Kategorik - numerik
3. Numerik - kategorik, dan
4. Numerik - numerik

·         Numerik Data

Data numerik adalah data metric atau data yang merupakan hasil pengukuran. Jika data hasil pengukuran eksakta menghasilkan data metrik murni (pure metric data), maka pada pengukuran sosial – humaniora, data yang dihasilkan bukan data metrik murni.
Pada pengukuran sosial-humaniora, suatu variabel dikonstruk sedemikian rupa dalam beberapa indikator yang kemudian menjadi dasar pembuatan item pengukuran. Pada setiap item disediakan beberapa pilihan jawaban yang pada dasarnya berbentuk kategorik ordinal. Untuk jawaban yang dipilih pada setiap indikator diubah ke bentuk angka yang disebut scoring. Meskipun kelihatannya sama, namun istilah coding dan scoring berbeda, yaitu:

Coding
Scoring
Diterapkan pada variabelmanifest, dimana setiap variabel hanya mengandung 1 item
Diterapkan pada variabel laten yang dikonstruk dari beberapa variabelmanifest (indikator), dimana setiap variabel mengandung beberapa item
Hasil coding per item dapat dianalisis langsung, karena setiap item mewakili 1variabel
Hasil scoring per item tak boleh dianalisis langsung, tapi harus dijumlahkan dengan score item-item lain yang mewakili variabel yang sama.
Data yang dihasilkan merupakan data kategorik baik nominal maupun ordinal
Data yang dihasilkan adalah data interval atau data ordinal yang diperlakukan sebagai data interval

Catatan: Data yang didapat sebagai penjumlahan skor-skor seluruh item pada suatu konstruk variabel laten dimasukkan dalam klasifikasi data interval. Namun ada yang merasa ragu dengan konsep scoring dan coding di atas, ”Apakah data ordinal yang dijumlahkan dapat menghasilkan data interval?”.
Karena itu dalam konteks seperti ini, jumlah skor-skor dari suatu konstruk dinyatakan diperlakukan sebagai data interval (threat as interval), meski sebenarnya dianggap bukan data interval.
1) Numerik Ordinal
Data numerik ordinal adalah data yang berupa angka yang menunjukkan urutan.
Contoh:
a) urutan antrian
b) urutan tempat duduk
c) urutan nomor rumah
d) urutan kemunculan
bentuk khusus data numerik ordinal ini adalah data ranking (rank –order), yaitu data yang dihasilkan dari pengurutan data interval atau rasio baik secara meningkat (ascending) maupun menurun (descending).
Seperti data kategorik ordinal, operasi matematika tak dapat dilakukan pada data ini.
Contoh: Tidak dapat dikatakan bahwa; ranking 3 – ranking 2 = ranking 1
Juga tidak dapat dikatakan bahwa; 2 x kali ranking 1 = ranking 2.
2) Numerik Interval
Data numerik interval selain mengandung unsur urutan juga memiliki unsur kesamaan jarak antar urutan. Karena itulah operasi bilangan dapat dilakukan.
Contoh: 40° C – 30° C = 10°C
40° C adalah 2x lebih panas dari 20° C.
Namun data numerik interval tidak memiliki 0 yang absolut.
Contoh: 0° C = 32° F
Siswa yang mendapat nilai 0 pada tes Statistika tidak dapat diartikan bahwa yang bersangkutan tidak memiliki pengetahuan sama sekali tentang Statistika.
Kesamaan jarak ukuran ini yang sulit dijamin pada suatu pengukuran sosial – humaniora. Karena itulah hasil pengukuran sosial – humaniora dianggap bukan data interval, tetapi data ordinal yang diperlakukan sebagai data interval.
Data numerik interval ini dapat diubah menjadi data:
a) numerik ordinal, dengan cara me-ranking-nya
b) kategorik ordinal, dengan cara mengkategorikannya.
3) Numerik Rasio
Data numerik rasio adalah data yang selain mengandung unsur urutan, memiliki jarak ukuran yang sama, serta memiliki nilai 0 absolut.
Contoh: Jika tidak ada sesuatu yang diletakkan di atas timbangan emas, maka angka digital yang tertera tetap angka 0,00.
Seperti data numerik interval, data numerik rasio ini dapat diubah menjadi data:
a) numerik ordinal, dengan cara me-ranking-nya
b) kategorik ordinal, dengan cara mengkategorikannya.

       Oleh karena arah pengujian dalam analisis 2 sisi tidak dapat ditentukan, maka jenis ketiga dan keempat ujinya sama.. Untuk uji kategorik-kategorik disebut uji beda proporsi, untuk uji no.2 dan 3 disebut uji beda rata-rata, dan uji keempat uji korelasi bivariat. Uji beda rata-rata terbagi 2 jenis : jika 2 rata-rata uji t-test dan apabila lebih dari 2 rata uji Anova.

         Pengujian / analisis data mengacu kepada tujuan penelitian. Dengan demikian, analisis data adalah sebuah upaya menggunakan statistik untuk menjawab tujuan penelitian. Ada beberapa langkah melakukan pengujian data yang mengacu kepada tujuan penelitian pada uji bivariate. Langkah-langkah pengujian ini disusun oleh penulis untuk memperkuat pemahaman bahwa statistik hanyalah sebuat alat bantu untuk mengambil keputusan atau kesimpulan. Artinya, tanpa statistik sebenarnya kesimpulan bisa diambil. Akan tetapi  untuk lebih meyakinkan atau apabila secara visuals sulit mengambil kesimpulan, maka digunakanlah statistik (uji). Dengan kata lain pemilihan jenis uji statistik disesuaikan dengan bentuk data, bukan sebaliknya data yang menyesuaikan dengan uji yang akan digunakan. Pada penjelasan berikut ini, tujuan penelitian sudah ada sebelumnya (pada proposal penelitian).
Anova (analysis of varian) digunakan untuk menguji perbedaan mean (rata-rata) data lebih dari dua kelompok. Misalnya kita ingin mengetahui apakah ada perbedaan rata-rata lama hari dirawat antara pasien kelas VIP, I, II, dan kelas III. Anova mempunyai dua jenis yaitu analisis varian satu faktor (one way anova) dan analsis varian dua faktor (two ways anova). Pada kesempatan ini hanya akan dibahas analisis varian satu faktor.

Uji Beda 2-Rata-rata (t-test)
·         Pengertian                                                                                   
           Di bidang kesehatan sering kali kita harus membuat kesimpulan apakah suatu intervensi berhasil atau tidak. Untuk mengukur keberhasilan tersebut kita harus melakukan uji untuk melihat apakah parameter (rata-rata) dua populasi tersebut berbeda atau tidak. Misalnya, apakah ada perbedaan rata-rata tekanan darah populasi intervensi (kota) dengan populasi kontrol (desa). Atau, apakah ada perbedaan rata-rata berat badan antara sebelumdengan sesudah mengikuti program diet. Sebelum kita melakukan uji statistik dua kelompok data, kita perlu perhatikan apakah dua kelompok data tersebut berasal dari dua kelompok yang independen atau berasal dari dua kelompok yang dependen/berpasangan. Dikatakan kedua kelompok data independen bila populasi kelompok yang satu tidak tergantung dari populasi kelompok kedua, misalnya membandingkan rata-rata tekanan darah sistolik orang desa dengan orang kota. Tekanan darah orang kota adalah independen (tidak tergantung) dengan orang desa. Dilain pihak, dua kelompok data dikatakan dependen/pasangan bila datanya saling mempunyai ketergantungan, misalnya data berat badan sebelum dan sesudah mengikuti program diet berasal dari orang yang sama (data sesudah dependen/tergantung dengan data sebelum).

Konsep Uji Beda Dua Rata-rata

        Uji beda rata-rata dikenal juga dengan nama uji-t (t-test ).  Konsep dari uji beda rata-rata adalah membandingkan nilai rata-rata beserta selang kepercayaan tertentu (confidenceinterval) dari dua populasi. Prinsip pengujian dua rata-rata adalah melihat perbedaan variasikedua kelompok data. Oleh karena itu dalam pengujian ini diperlukan informasi apakah varian kedua kelompok yang diuji sama atau tidak. Varian kedua kelompok data akan berpengaruh pada nilai standar error yang akhirnya akan membedakan rumus pengujiannya.Dalam menggunakan uji-t ada beberapa syarat yang harus dipenuhi. Syarat/asumsi utama yang harus dipenuhi dalam menggunakan uji-t adalah data harus berdistribusi normal.Jika data tidak berdistribusi normal, maka harus dilakukan transformasi data terlebih dahulu untuk menormalkan distribusinya. Jika transformasi yang dilakukan tidak mampu.  menormalkan distribusi data tersebut, maka uji-t tidak valid untuk dipakai, sehingga disarankan untuk melakukan uji non-parametrik seperti Wilcoxon (data berpasangan) atauMann-Whitney U (datindependen).Berdasarkan karakteristik datanya maka uji beda dua rata-rata dibagi dalam dua kelompok, yaitu: uji beda rata-rata independen dan uji beda rata-rata berpasangan.

Ø  Aplikasi Uji-t Dependen pada Data Berpasangan

         Uji-t untuk data berpasangan berarti setiap subjek diukur dua kali. Misalnya sebelum dan sesudah dilakukannya suatu intervensi atau pengukuran yang dilakukan terhadap pasangan orang kembar. Dalam contoh ini akan membandingkan data sebelum dengan sesudah intervensi. Dalam BAYI95.SAV sudah ada data berpasangan yaitu pengukuran berat badan ibu yang dilakukan sebelum hamil. Sebelum merencanakan kehamilan, subjek melakukan penyesuaian diet (mengikuti program makanan tambahan) selama 2 bulan.Pengukuran berat badan yang pertama (BBIBU_1) dilakukan sebelum kegiatan penyesuaian diet dilakukan, dan pengukuran berat badan yang kedua (BBIBU_2) dilakukan setelah dua bulan menjalani penyesuaian diet.Kita akan melakukan uji hipotesis untuk menilai apakah ada perbedaan berat badan ibu antara sebelum dengan sesudah mengikuti program diet, langkah-langkahnya sebagaiberikut.1. Bukalah file BAYI95.SAV, sehingga data tampak di Data editor window.

2. Dari menu utama, pilihlah: (pada SPSS 10.0)
     < Compare Mean
     < Paired-Sample T-test
 3.Pilih variabel BBIBU_1 danBBIBU_2
dengan cara mengklik masing-masing variable tersebut.
 Kemudian klik tanda
     <untuk memasukkannya ke dalam kotak Paired-Variables.
4. Pada menu “
      Options
  pilihlah derajat kepercayaan yang diinginkan, misalnya 95%.Kemudian pilih
      Continue
     Klik OK

Ø    Aplikasi Uji-t pada Data Independen
         Uji-t untuk data independen dilakukan terhadap dua kelompok data yang tidak saling berkaitan antara satu dengan lainnya. Misalnya membandingkan kelompok intervensi dengan kelompok kontrol atau kelompok ibu-ibu perokok dengan ibu-ibu bukan perokok adalah dua kelompok yang tidak saling berkaitan.Pada analisis ini kita akan melihat apakah ada perbedaan berat bayi yang lahir dari ibu perokok dengan bayi yang lahir dari ibu bukan perokok. Kita akan melakukan uji hipotesis apakah ada perbedaan rata-rata berat bayi yang lahir dari ibu bukan perokok dengan rata-rata berat bayi yang lahir dari ibu perokok, dengan langkah-langkah sebagai berikut.1. Bukalah file BAYI95.SAV, sehingga data tampak di Data editor window.2.
       
 UJI ANALISIS VARIANSI (ANOVA)
Beberapa asumsi yang harus dipenuhi pada uji Anova adalah:
  1. Sampel berasal dari kelompok yang independen
  2. Varian antar kelompok harus homogen
  3. Data masing-masing kelompok berdistribusi normal
         Asumsi pertama harus dipenuhi pada saat pengambilan sampel yang dilakukan secara random terhadap beberapa (> 2) kelompok yang independen, yang mana nilai pada satu kelompok tidak tergantung pada nilai di kelompok lain. Sedangkan pemenuhan terhadap asumsi kedua dan ketiga dapat dicek jika data telah dimasukkan ke komputer, jika asumsi ini tidak terpenuhi dapat dilakukan transformasi terhadap data. Apabila proses transformasi tidak juga dapat memenuhi asumsi ini maka uji Anova tidak valid untuk dilakukan, sehingga harus menggunakan uji non-parametrik misalnya Kruskal Wallis.

       Uji Anova pada prinsipnya adalah melakukan analisis variabilitas data menjadi dua sumber variasi yaitu variasi didalam kelompok (within) dan variasi antar kelompok (between). Bila variasi within dan between sama (nilai perbandingan kedua varian mendekati angka satu), maka berarti tidak ada perbedaan efek dari intervensi yang dilakukan, dengan kata lain nilai mean yang dibandingkan tidak ada perbedaan. Sebaliknya bila variasi antar kelompok lebih besar dari variasi didalam kelompok, artinya intervensi tersebut memberikan efek yang berbeda, dengan kata lain nilai mean yang dibandingkan menunjukkan adanya perbedaan.
Berdasarkan banyaknya variable bebas-nya, Analisis Variansi Univariate dibagi menjadi tiga kelompok yaitu
1.      Analisis Variansi Univariate Satu Jalan
Analisis ini digunakan jika suatu eksperimen mempunyai satu variable terikat dan satu variabel bebas
2.      Analisis Variansi Univariate Dua Jalan
Analisis ini digunakan jika suatu eksperimen mempunyai satu variable terikat dan dua variabel bebas
3.      Analisis Variansi Univariate Tiga Jalan
Analisis ini digunakan jika suatu eksperimen mempunyai satu variable terikat dan tiga variabel bebas

Berdasarkan banyaknya variable bebas-nya, Analisis Variansi Multivariate juga dibagi menjadi 3 bagian yaitu
1.      Analisis Variansi Multivariate Satu Jalan
Analisis ini digunakan jika suatu eksperimen mempunyai lebih dari satu variable terikat dan satu variabel bebas
2.      Analisis Variansi Multivariate Dua Jalan
Analisis ini digunakan jika suatu eksperimen mempunyai lebih dari satu variable terikat dan dua variabel bebas
3.      Analisis Variansi Multivariate Tiga Jalan
Analisis ini digunakan jika suatu eksperimen mempunyai lebih dari satu variable terikat dan tiga variabel bebas
Rumus uji Anova adalah sebagai berikut :
DF = Numerator (pembilang) = k-1,  Denomirator (penyebut) = n-k
Di mana varian between :


Dimana rata-rata gabungannya :

Sementara varian within :

KETERANGAN :
Sb = varian between
Sw = varian within
Sn2 = varian kelompok
X = rata-rata gabungan
Xn = rata-rata kelompok
Nn = banyaknya sampel pada kelompok
k = banyaknya kelompok